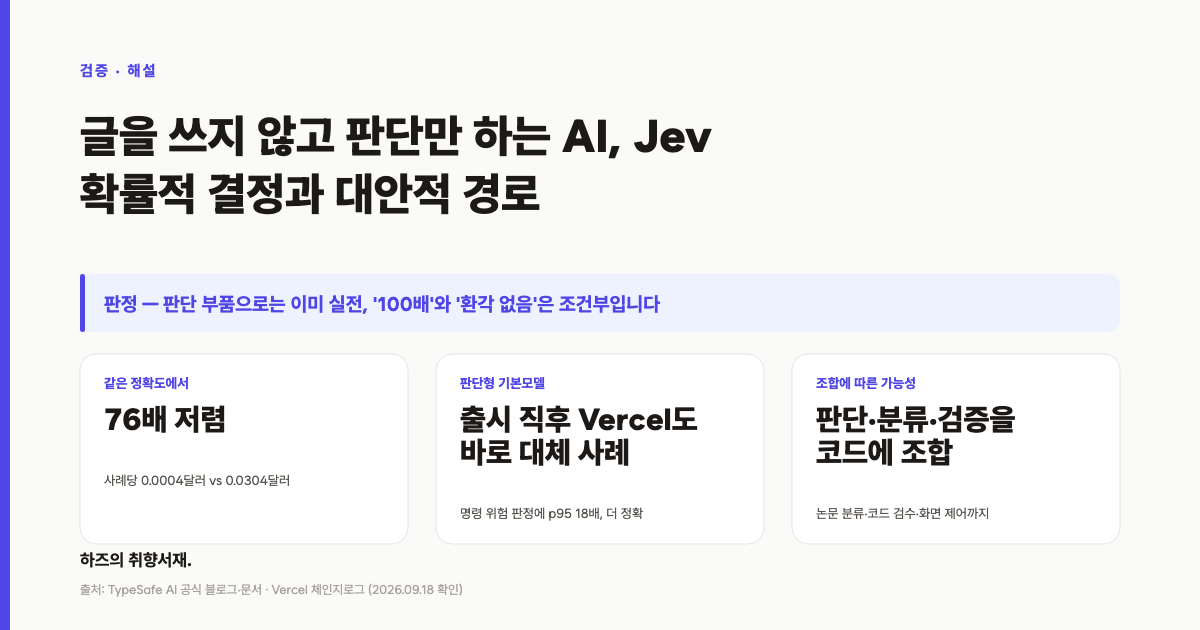
프롬프트 대신 판단만 해서 확률적 결정을 내리는 Jev
대안적 경로로 AGI를 향하다
Jev는 문장을 만들지 않습니다. 상태(state)를 넣으면 정해 둔 질문에 확률과 확신도가 붙은 결정이 돌아옵니다. 만든 사람은 ChatGPT의 바탕이 된 연구에 참여한 디오고 알메이다이고, 공개 이틀 만에 Vercel의 코딩 도구가 명령 위험 판정의 기본 모델로 채택했습니다. TypeSafe의 공식 자료와 실사용 기록 43건으로 무엇이 증명됐고 어디까지가 광고인지 확인했습니다. 직접 돌려 본 화면 조작 작업에서 판단은 0.48초, 이미지를 볼 수 있는 모델에 맡기면 1.92초에서 33.4초였습니다. "100배"와 "환각 없음"은 조건을 떼면 과장입니다.
00결론부터 보기
- ❓ 프롬프트 대신 판단만 한다는 것. 정확히는 지시문 대신 질문지입니다. 미리 정해 둔 질문에만 답을 받고, 자유 서술이 아니라 선택지 목록과 채점 기준을 함께 보냅니다. 상태(state)를 보내는 것 자체는 요청이라 "프롬프트가 아예 없다"는 뜻은 아닙니다.
- 🎯 확률적 결정이 핵심입니다. 답에는 선택지별 확률분포와 확신도가 함께 옵니다. 확신도는 답이 아니라 행동을 가르는 값으로, 높으면 자동 처리, 중간이면 확인, 낮으면 사람에게 넘깁니다. 문서 기준의 바닥값은 0.6, 되돌릴 수 없는 동작은 0.85입니다.
- 🧭 AGI는 TypeSafe의 목표가 아니라 창업자의 출발 질문입니다. 선언문(매니페스트)은 AGI 추격을 명시적으로 거부합니다. "우리는 계속 움직이는 AGI라는 목표를 쫓지 않는다. 오늘 모델은 이미 경제적 가치를 만들 만큼 똑똑하다. 병목은 지능이 아니라 그 지능을 쌓아 올리기 어렵다는 것이다." 슬로건은 "Build Prod, Not God"입니다.
- 📐 실전 사례가 하나 있습니다. Vercel의 코딩 도구 fx가 자동 모드의 명령이 위험한지를 판정하던 모델(심사자)을 GPT-5.6 Luna에서 Jev로 바꾸는 변경을 저장소에 병합했습니다(2026년 9월 17일). CEO는 "응답이 가장 느린 5% 구간을 기준으로도 최대 18배 빠르고 더 정확하다"고 밝혔습니다. 판정이 실패하면 사람이 승인해야 끝납니다.
- 📊 커뮤니티 실측은 "싸고 빠르다"까지 검증됩니다. 논문 1,018편 분류에 0.08달러와 논문당 중앙값 256밀리초, 코드 리뷰는 건당 0.00007달러. 정확도가 비슷한 모델의 비용은 약 76분의 1이고, 가장 정확한 모델은 6점 높고 200배 비쌉니다. 정확도는 좁은 판정에서 동급 이상, 어려운 판단에서 뒤졌습니다.
- 🧩 네이밍 자체가 사업의 방향성입니다. Jev는 경제학자 제번스에서, System One은 카너먼의 1체계에서 왔습니다. 증기기관 효율이 오르자 석탄 수요가 늘었듯, 판단 비용이 10분의 1로 떨어지면 쓰임새는 10배로 늘어난다고 본 쪽입니다. 비싸서 못 하던 판단을 새로 만들어 내겠다는 쪽입니다.
- 🧪 직접 돌려 본 값도 같은 쪽이었습니다. 화면 조작 예제를 macOS에서 돌려 보니 판단이 0.48초, 이미지를 볼 수 있는 모델에 맡기면 1.92초에서 33.4초였고, 실행 전체로는 1.2배에서 4.6배 빨랐습니다.
01Jev가 하는 일: 상태를 넣으면 결정이 나옵니다
쓰는 방법은 한 문장입니다. 상태 하나와 질문 여러 개를 한 번 보내면 질문마다 답이 병렬로 돌아옵니다. 상태에는 글, 데이터 묶음(JSON 객체), 목록을 넣을 수 있습니다.
TypeSafe의 정의는 "프런티어급 지능을 함수 호출처럼 쓰는 것: 구조가 정해지지 않은 상태를 넣으면, 타입이 정해진 확률적 결정이 나옵니다"입니다.
답은 질문 이름을 그대로 유지한 채 돌아오고, 선택형과 점수형에는 확률분포와 확신도가 붙습니다. 질문을 늘려도 응답 시간이 거의 늘지 않는데, 같은 상태에 대해 병렬 평가하기 때문입니다. 호출 경로는 POST https://api.typesafe.ai/v1/systemone 하나, 모델 이름은 jev-latest입니다. 플레이그라운드, 파이썬 SDK(3.10 이상), 코딩 도구용 스킬로 붙일 수 있습니다.
질문은 세 종류
선택형(Choice)은 정해 둔 목록에서 하나를 고르고, 점수형(Score)은 정해 둔 단계 위에 위치를 매기며, 예·아니오형(Noul)은 그럴 확률을 0~1로 돌려줍니다. 예·아니오형에는 확신도가 따로 붙지 않는데, 확률 자체가 답이기 때문입니다. 점수형은 2~10개 단계로 돌아오는 점수는 단계 사이에 놓일 수 있습니다. 예·아니오형의 0.5는 "예와 아니오의 확률이 같다"는 뜻입니다.
| 유형 | 돌려주는 것 | 실제 질문 예 | 돌아오는 답의 예 |
|---|---|---|---|
| 선택형 | 고른 항목 · 선택지별 확률 · 확신도 | 이 티켓은 어느 팀인가 | 결제팀 · 결제팀 0.72 · 0.81 |
| 점수형 | 점수 · 단계별 확률 · 확신도 | 이 고객은 얼마나 화가 났나 | 화남 3단계 · 단계별 확률 0.14/0.61/0.25 · 0.74 |
| 예·아니오형 | 예일 확률(0~1) | 이 메시지가 환불 요청인가 | 예일 확률 0.93 |
못 하는 것
문장과 코드를 만들지 못해 요약문·번역문·메일 초안은 다른 모델이 써야 하고, 이미지·오디오·영상은 "아직"이라 그림은 앞단에서 글자로 바꿔 넣습니다. 여러 단계를 이어 생각해야 하는 과제에는 큰 추론 모델보다 못하고, 틈새 분야 지식은 없지만 판단에 필요한 자료를 함께 넣으면 됩니다. 비슷한 입력에는 비슷한 답이 돌아오고, 형식은 깨지지 않지만 고른 선택지가 틀릴 수 있습니다. 한 번에 고르는 선택지는 255개까지입니다.
비용과 응답 속도
입력 토큰(AI가 읽는 글자 묶음 단위) 100만 개당 0.042달러, 출력 토큰은 무료입니다. 응답 지연은 70~500밀리초, 처리 한도는 초당 25만 토큰·분당 1,200회(예고 없이 바뀔 수 있음)이고, 서버가 미국 서부라 국내에서 쓰면 왕복 시간이 더 붙습니다. 실측은 고객 지원 27개 질문에 0.114초·0.000081달러, 같은 화면의 언어모델은 8.566초·0.013880달러로 약 75배 빠르고 171배 저렴합니다.
02LLM과의 차이
차이는 속도가 아니라 답을 만드는 방식에서 나옵니다. 언어모델은 문장을 한 토큰씩 이어 붙여 답을 만들고, 그 문장을 프로그램이 다시 해석합니다. Jev는 미리 정해 둔 선택지에 점수를 매겨, 형식이 깨질 여지가 없고 매기는 일은 한 번에 끝납니다.
요약 영상의 두 문장
Wasp 대표 Matija Sosic이 런치 영상을 46초로 다시 설명한 영상이 퍼졌습니다. 언어모델이 문장을 한 토큰씩 찍어 8.5초를 쓰는 장면과, 같은 물음에 Jev가 세 선택지를 확률로 한 번에 채점해 0.1초에 끝내는 장면이 나옵니다. "토큰이 없다. 한 번의 병렬 처리다", "글을 쓸 수 없다. 내가 준 선택지 중 하나를 가리킬 뿐이다".
확률과 확신도: 답이 아니라 행동을 정하는 값
실제 차이는 답에 붙는 확률분포입니다. 분포가 한쪽에 몰려 있으면 확실한 답이고 퍼져 있으면 애매한 답이며, TypeSafe는 그 모양을 확신도라는 한 숫자로 접어 제공합니다. 확신도는 확률분포에서 계산한 통계값이라 분포가 함께 오면 자기 기준으로 다시 계산할 수 있습니다. 이 구조가 없으면 자동화가 안전해지지 않는다는 것이 TypeSafe의 주장이고, 뒤의 실무 사례 대부분이 이 구조를 전제로 합니다.
LLM과의 유사점/차이점 정리
| 항목 | LLM과 유사/차이점 |
|---|---|
| 출력 형태 | 언어모델은 문장을 순서대로 만들어 내고, Jev는 준비된 선택지 중 하나를 확률과 함께 골라 냅니다. 소형 언어모델을 이런 식으로 Jev처럼 바꾸려는 시도들도 나타나고 있습니다 |
| 속도·비용 | 같은 판단을 훨씬 빠르고 싸게 처리합니다. TypeSafe의 주장이 아니라 Vercel이 기본값으로 바꾼 사실이 이를 뒷받침합니다 |
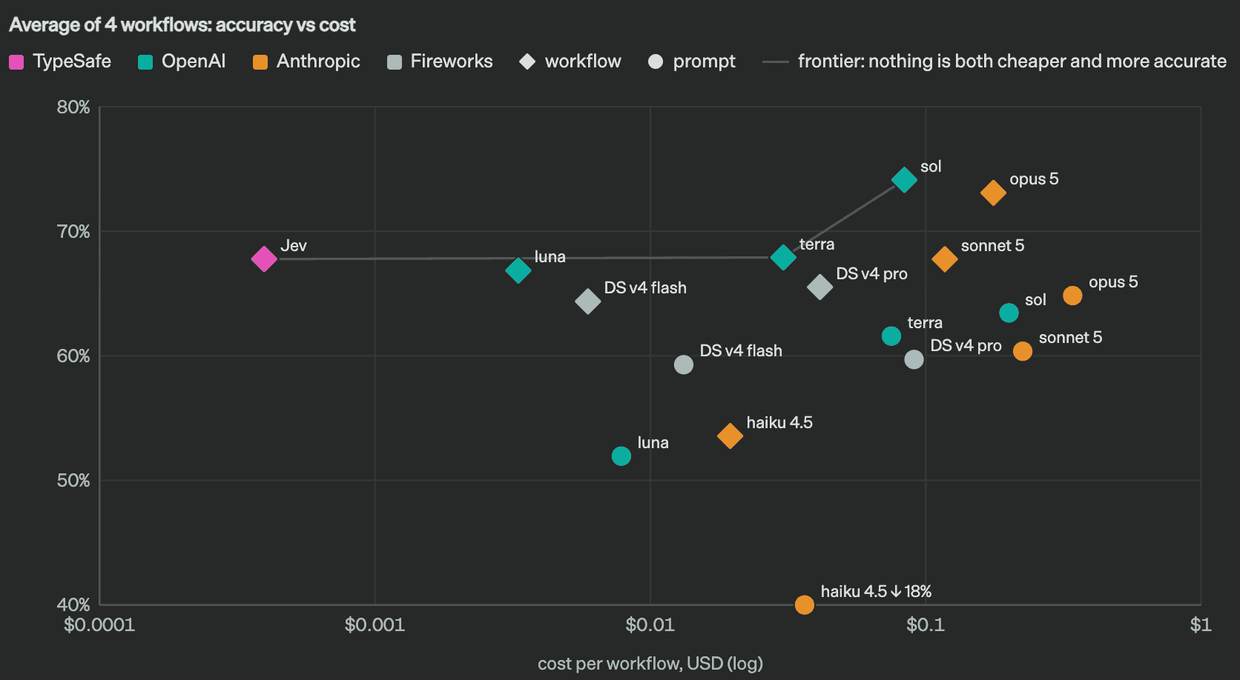
| 정확도 | 과제에 따라 다릅니다. TypeSafe 평가에서는 같은 크기의 일반 언어모델과 사실상 비슷했고(67.8% 대 67.9%), 좁은 분류·인젝션에서는 동급 이상이었습니다. 피싱 판정에서만 62.6% 대 81.3%로 뒤졌는데, 이는 다른 결과에 비해 의외로 나온 수치입니다 |
| 자유도 | 문장을 쓰지 않고 준비된 선택지 안에서만 답합니다. 자유로운 글쓰기는 못하지만 범주만 잘 좁혀간다면 그 신뢰도가 높습니다 |
| 판단의 책임 | 내 쪽으로 옮겨옵니다. 지금은 모델이 다음 도구를 골라 그 과정이 잘 보이지 않지만, Jev를 쓰면 판단은 확률로 오고 분기 로직은 내 코드에 남습니다 |
Replit의 네이선 플러리는 "Jev는 정말 똑똑한 switch 문"이라면서 동시에 "Jev는 GPT나 클로드를 대체하지 않는다"고 못 박았습니다. 게임 화면 상태를 넣고 다음 행동을 받는 데모는 초당 약 10회 호출에 시간당 약 7달러였고, 강조점은 "코드 루프 안에서 도는 판단"이었습니다(이 데모도 구조화된 상태 데이터 입력).
03창업자, 제품 철학, 모델명 Jev의 유래
제품이 왜 이 모양인지는 만든 사람과 그들이 먼저 발표한 주장에서 나옵니다. 철학 자료는 세 편입니다. 블로그 「The Bitterest Lesson」(가장 쓰라린 교훈, 9월 10일)과 블로그 「Lies, Damned Lies, and Benchmarks」(벤치마크 반대 글, 9월 11일), 그리고 선언문 「Composable AI: Build Prod, Not God」입니다. 블로그 두 편은 제품 공개(9월 15일)보다 먼저 올라왔습니다.
만든 사람
CEO 디오고 알메이다는 RLHF와 InstructGPT를 함께 만든 연구자이고, 그 작업이 ChatGPT·GPT-4로 이어졌습니다. COO 사샤 셩은 Meta의 FAIR 출신, CTO 에릭 가프니는 기업가치 10억 달러 넘는 회사 두 곳의 초기 멤버입니다. 2년간 비공개로 개발해 4,000만 달러 시드 투자(대표 투자자 DCVC)를 받았다고 발표했습니다.
철학 세 편과 제품 설계
"더 똑똑한 모델"이 아니라 조합 가능한 부품을 만들겠다고 선언합니다. 오늘의 모델은 SQL 이전의 데이터베이스처럼 쓰임마다 맞춤 제작이라 쌓아 올릴 수 없고, 그래서 문장(자유도)을 버리고 타입이 정해진 값만 내보내 실패해도 형식이 깨지지 않게 했습니다. "가장 쓰라린 교훈" 글은 올바른 과제 > 데이터 > 계산 > 알고리즘을 주장하고, 벤치마크 반대 글에서 공개 점수를 내지 않기로 했습니다. "요청해도 고객 데이터로 학습하지 않는다"는 것도 밝혔습니다.
모델을 설명하는 'System One'과 'Jev' 두 이름에 담긴 뜻
둘 다 상식이 예상하는 반대쪽을 골라 지은 이름입니다. System One은 카너먼의 『생각에 관한 생각』에서 온 빠르고 직관적인 1체계인데, 상식은 "빠르고 직관적인 판단은 틀리기 쉽다"고 말하지만 TypeSafe는 "System One 모델은 다른 대안보다 더 신뢰할 수 있게 만들 수 있다"고 적었습니다. Jev는 경제학자 제번스에서 왔습니다. 증기기관의 효율이 오르자 석탄은 덜 쓰인 게 아니라 더 쓰였고, 판단 비용이 10분의 1로 떨어질 때마다 쓰임새는 10배로 늘어난다는 쪽입니다.
04숫자에 붙은 조건
TypeSafe가 낸 숫자는 크지만 대부분 조건이 붙어 있습니다. 조건을 떼면 과장이 되고, 붙이면 쓸 만한 지표가 됩니다.
| 주장 | 실제 조건 |
|---|---|
| 환각이 없다 | 만들 수 있는 출력이 미리 정한 선택지뿐이라 없는 사실을 지어낼 자리가 없습니다. 선택지는 잘못 고를 수 있고 확률이 틀릴 수도 있습니다 |
| 20~200배 빠르고 40~1,000배 싸다 | 같은 질문을 병렬로 채점하는 조건입니다. 문장 하나를 받아 쓰는 일은 하지 못합니다. 배수는 콘솔 안내가 비용 40~1,000배, 창업자 게시물이 40~400배로 서로 다릅니다 |
| 193.6배 빠르고 444.6배 저렴 | 자기 워크플로 4종에서, 자기가 만든 정답 기준값(기준 라벨)에 대고 잰 값입니다. TypeSafe도 "실제 이득의 상단", "평가에 편향이 있을 수 있다"고 적었습니다 |
| 출력 토큰 무료 | 입력은 유료입니다. 출력이 짧고 입력이 긴 구조라 청구서는 입력에서 나옵니다. TypeSafe도 "보조금이 아니라고 증명할 수는 없다"고 밝혔습니다 |
| 구조화 출력 오류율 0% | TypeSafe가 "실측이 아니다. 형식 일치(스키마)가 보장되므로 0%를 넣었다"고 밝힌 값입니다. 정답률이 아니라 형식이 어긋나지 않는다는 뜻입니다 |
형식 오류율 지표는 답이 아니라 정해 둔 형식을 지켰는지를 잽니다. Jev가 0%인 것은 잘해서가 아니라 어길 형식이 없어서입니다.
정확도가 사실상 같을 때 비용은 약 76분의 1, 시간은 약 25분의 1이고, 가장 정확한 모델은 6.3점 높은 대신 사례당 209배 비쌉니다. 대체 대상은 가장 정확한 모델이 아니라 분류와 판정에 쓰이던 가운데 등급 모델의 호출입니다.
같은 모델이라도 프롬프트 하나로 모든 판단을 맡기면 정확도가 떨어집니다(Terra 67.9→61.6%, Sol 74.1→63.4%). 판단을 쪼개 워크플로로 짠 쪽이 더 정확했습니다.
TypeSafe가 스스로 단 각주 다섯 개
평가는 미국 서부의 자사 노트북 값이고(국내는 왕복 지연이 더 붙습니다), 언어모델 기준값은 출력 형식을 강제하는 보조 장치를 거친 값이라 배수가 부풀려졌을 여지가 있습니다. 기준 답안이 GPT-6 Astra와 Fable 5.1의 평균이라 그 계열에 기울었고, 데모에서 답이 갈린 항목은 실제로 애매한 질문이었습니다. 싼 가격을 오래 유지할 수 있는지는 아무도 증명하지 못했습니다.
05공개 직후 나온 반론
공개 직후 해커뉴스에 추천 1,855점 토론에 댓글 160개가 넘게 붙었습니다. 가장 많이 지적받은 표현은 "환각이 없다"였습니다. 글을 만들지 않으면 환각도 없다는 것은 너무 쉬운 조건인데 대단한 것처럼 말한다는 지적, 비생성 모델은 환각하는 게 아니라 그냥 틀린다는 정리가 그렇습니다. 비교의 공정성, 벤치마크를 내지 않은 결정에 대한 의심, 인코더(글을 숫자로 바꿔 분류하는 경량 모델) 기반 분류기 아니냐는 질문, 기준값의 경쟁 모델 편향(TypeSafe도 인정), 폐쇄형과 단가 유지 문제도 지적됐습니다.
실무적으로 가장 값진 지적은 확신도를 어디까지 믿느냐였습니다. 개발자 서평에는 "확신도는 라우팅용 메타데이터이지 안전의 증거가 아니다. 확신 있게 틀린 '이 명령은 안전하다'는 여전히 위험한 결과다"라는 문장이 있습니다. 다만 반론 대부분은 표현과 조건을 겨눈 것이고, 실제로 남는 것은 확신도를 안전의 증거로 쓰지 말라는 지적 하나입니다.
06실무 적용
Jev는 스스로 판단해 갈래를 고르는 IF문에 가깝습니다. 다만 그 IF문이 고르는 근거는 사람이 쓴 규칙이 아니라 데이터에서 배운 확률이고, 판단은 Jev가 하지만 그 판단을 받아 실행할 분기는 내 코드에 남습니다.
지금까지는 모델에게 사람이 읽을 문장을 만들어 달라고 시켰고, 프로그램은 그 문장을 다시 읽어 해석해야 했습니다. Jev는 프로그램이 그대로 쓸 수 있는 값(선택지·점수·확률)을 받으니 해석 단계가 없고, 대신 문장을 쓸 수 없다는 제약이 붙습니다.
적용 갈래는 다섯입니다. 사람 없이 수백만 번 도는 자동화, 실시간 화면·게임, 큰 데이터의 분류와 검색, 다른 AI의 입력·출력·도구 호출 검사, 에이전트 실행틀(하네스) 자체를 똑똑하게 만드는 일입니다. 검사에 드는 비용이 원래 호출보다 훨씬 싸다는 것이 요점이고, 국내 실무로 옮기면 "AI가 만든 답변을 사람이 표본으로 검수한다"를 "전수로 검수한다"로 바꾸는 일입니다. 아래 표는 산업별 후보 중 커머스에 가까운 것만 추린 것입니다.
| 업무 장면 | 던질 질문 | 사람이 하던 일 |
|---|---|---|
| 고객 문의 분류·배분 | 선택형 | 티켓을 읽고 어느 팀인지 정하기 |
| 우선순위·긴급도 판단 | 점수형 + 예·아니오형 | 급한지 회의로 판단 |
| 기획 검토서·안내 문구 점검 | 예·아니오형 | 정책에 어긋나는 표현 찾기 |
| 상품·콘텐츠 자동 분류 | 선택형 + 점수형 | 카테고리·속성 수기 입력 |
| AI 답변 품질 관리 | 예·아니오형 묶음 | 검수자가 표본 검사 |
| 어느 모델로 보낼지 결정 | 선택형 | 어느 모델로 보낼지 정하는 규칙을 손으로 씀 |
붙이기 전에 정해 둘 것은 다섯 가지입니다. 확신도 문턱을 업무별로 다르게 잡고(되돌릴 수 있는 일은 낮게, 정산·전시 변경은 높게), 확신할 수 없으면 자동 처리를 멈추고 사람에게 넘기며, 낮은 확신도의 답이 뒤 단계로 넘어가지 않게 막고, 고객에게 보낼 문장은 다른 모델이 쓰게 하며, 정답을 붙인 표본으로 확신도가 실제로 맞는 비율을 먼저 확인합니다.
검색에서 응답 속도를 줄일 수 있는 조건
검색 파이프라인에서 느린 곳은 검색 자체가 아니라 그 뒤의 판단입니다. 후보 문서를 한꺼번에 넣고 관련도 점수만 받아 상위 몇 건만 프롬프트에 넣자는 제안이 X에 올라왔는데, 성립하는 구간은 1차 검색 뒤에 후보를 다시 매기는 재정렬 구간입니다. 상태 크기 상한과 255개 선택 제한이 있고, 비용이 먼저 걸립니다(1,000건 채점에 약 0.021달러, 하루 1만 건이면 약 210달러). 실측은 분류 쪽만 있고(논문 1,018편 0.08달러), 관련도 채점은 아이디어 단계입니다.
묶어 묻기와 호출 횟수
같은 문서에 여러 질문을 할 때 호출을 몇 번 하는지가 비용과 시간을 가릅니다. 5만 4천 자짜리 문서에 질문 13개를 던질 때 한 번에 묶으면 호출 1회·0.000497달러·0.27초, 질문마다 따로 하면 호출 13회·0.006090달러·2.71초였습니다. 12.2배 저렴하고 10.0배 빠르며 답은 같았습니다. 같은 문서를 13번 다시 보내는 대신 한 번만 내기 때문이고, 문서가 클수록 절감 폭이 질문 수에 가까워집니다. 직접 재현한 값도 같은 방향입니다(문서 6천 자, 질문 13개: 8.4배 저렴, 5.4배 빠름).
07화면 조작(computer use)
판단만 하던 부품인데 화면 조작 자동화에까지 쓰이는 사례가 나왔습니다.
화면 조작(computer use)에 붙인 공개 사례
화면 조작 드라이버 Cua Driver가 Jev를 붙인 'jev-use'를 공개했고, 2048 게임 실행에서 Jev가 GPT-6 Astra보다 5배 빠르고 약 1,000배 저렴했다는 값을 함께 냈습니다(그들은 "이 실행 하나의 값"이라고 못 박았습니다). Cua는 예제를 자기 저장소에 병합하고(9월 18일) 같은 방식의 자체 모델 CUA-S1도 열기 시작했는데, 초기 연구 단계라 실제 효과 검증은 더 지켜봐야 합니다.
화면을 글자로 바꿔 판단만 맡기는 방식도 있습니다. 오픈마우스봇을 만든 Milind Soni는 기기 안에서 화면을 잘라내고 글자 인식으로 텍스트를 만들어 Jev에 다음 행동을 확률로 물었습니다. 결정 한 번은 약 90밀리초이고 화면 그림과 화면 구조(DOM)는 기기 밖으로 나가지 않습니다.
macOS 화면을 글자 인식으로 읽어 클릭하는 저장소(Andrew Levin)는 단계당 약 0.0002달러로 적었습니다.
공개 예제를 직접 돌려 본 값
macOS에서 Cua Driver 0.28.2로 격리 브라우저를 열고 로컬 폼의 입력·제출 두 단계를 맡겼습니다. 제출값으로 성공을 따로 확인해 두 번 모두 통과했고, 판단 네 번은 822·260·698·249밀리초(중앙값 478밀리초)였습니다.
| 순서 | 단계(무엇을 하는가) | 걸린 시간 |
|---|---|---|
| 준비 | 격리 브라우저 준비(새 임시 프로필 만들기·창 열기·폼 페이지 이동) | 6,226밀리초 |
| 1 | 브라우저 상태 읽기(열린 화면의 요소를 글자 목록으로 뽑아 Jev에 넣을 입력을 만듦) | 5.5밀리초 |
| 2 | Jev 결정(입력을 보고 다음에 무엇을 할지 고름. 네 번 판단의 중앙값) | 478밀리초 |
| 3 | 드라이버 실행(정한 동작을 손으로 옮김. 값 입력, 제출 클릭) | 1,599밀리초 |
| 합계 | 1~3의 한 단계(이 작업은 이를 두 번 반복) | 2,108밀리초 |
| 전체 | 준비 + 두 단계 | 11,150밀리초 |
| 비용 | 두 단계의 모델 호출(입력 토큰 1,307개) | 0.000055달러 |
화면 조작에서 발목을 잡던 판단이 0.5초 아래로 내려온 것이 이 구성의 요점이고, 남은 시간은 대부분 손이 쓰는 시간입니다. 판단 주체만 언어모델 다섯 개로 바꿔 같은 조건에서 재봤습니다.
| 판단 주체 | 결정 | 단계 전체 | 실행 전체 | 출력 토큰(추론 포함) |
|---|---|---|---|---|
| Jev | 0.48초 | 2.1초 | 11.1초 | 45~53 (추론 없음) |
| GPT-5.6 Luna | 1.92초 | 3.5초 | 13.9초 | 22~28 (10~16) |
| DeepSeek V4.1 Flash | 2.81초 | 4.5초 | 16.7초 | 74~353 (67~342) |
| Gemini 3.8 Flash | 4.06초 | 5.7초 | 20.1초 | 92~270 (82~260) |
| Grok 4.6 | 5.03초 | 6.6초 | 22.2초 | 240~469 (231~459) |
| Muse Spark 1.3 | 8.8~33.4초 | 18.4초 | 35.7~51.7초 | 509~2,211 (490~2,194) |
판단 시간 차이는 4.0배에서 35.0배이고, 실행 전체로는 준비와 클릭이 고정이라 1.2배에서 4.6배로 좁혀집니다. 언어모델은 세 후보 가운데 고르는 데 10~2,194토큰을 추론에 쓰는데 Jev는 45~53토큰이면 끝납니다.
화면 이미지까지 함께 준 조건도 재봤습니다. 창을 JPEG로 캡처해 다섯 개 모델에 글자 상태와 함께 넣었습니다.
| 판단 주체 | 결정 | 실행 전체 | 입력 토큰(두 단계) | 비용 |
|---|---|---|---|---|
| Jev(텍스트만) | 0.48초 | 11.1초 | 1,307~1,311 | 실행당 0.000055달러 |
| GPT-5.6 Luna(화면 포함) | 3.18초 | 17.6초 | 1,239~1,241 | 미확인 |
| DeepSeek V4.1 Flash(화면 포함) | 3.82초 | 20.9초 | 1,210~1,216 | 미확인 |
| Gemini 3.8 Flash(화면 포함) | 4.11초 | 19.1초 | 2,921~2,934 | 미확인 |
| Grok 4.6(화면 포함) | 11.57초 | 32.3초 | 1,662 | 미확인 |
| Muse Spark 1.3(화면 포함) | 12.12초 | 33.3초 | 1,278~1,280 | 미확인 |
격차는 줄지 않았습니다(6.6배에서 25.3배). 다만 화면 이미지는 입력 토큰을 크게 늘리고(Gemini 3.8 Flash는 세 배에서 다섯 배), 그 몫은 판단에 쓰이지 않아도 청구됩니다. Muse Spark 1.3은 글자 조건 네 번 가운데 두 번 판단을 보류해 화면 조건에서만 통과했습니다.
확신도는 이 예제에서 실행을 막지 않았습니다. 되돌릴 수 없는 제출에 붙은 확신도가 0.33과 0.41인데도 실행됐는데, 문서 기준(0.85 이상)과 다릅니다. 예제는 확신도를 넘겨 주기만 하고 쓰는 쪽이 정하기 때문이고, 업무에 쓴다면 문턱을 두어야 합니다.
휴대폰에 붙인 기록도 있습니다. 루드라는 "로그인하고, 여행 경비 900루피를 넣고, 다크 모드를 켜라"는 문장으로 열 단계를 모두 통과했고, 판단 한 번에 약 400밀리초, 실행 전체 비용은 0.0006달러였습니다.
08실제 사용 기록 43건
공개 뒤 나흘 동안 올라온 기록 27건을 원문으로 열어 확인했고, 그 뒤의 제3자 검증 7건과 화면 조작 기록 2건, 도구 사례 3건, 목록 사이트(Jevable) 확인분 4건을 더해 모두 43건입니다. 목록 사이트 두 곳은 각각 359건(Jevable)과 186건(madewithjev)을 등록해 두었지만 신고를 모은 수이고, 43건은 원문과 코드로 확인이 끝난 것만 남긴 수입니다. 처음 모은 27건은 공식 확인 5건, 작성자 실측 주장 7건, 근거 없는 데모 11건, 걸러낸 과장 3건, 이미 반영 1건이었습니다.
| 사례 | 숫자 | 확인된 내용 |
|---|---|---|
| Vercel 코딩 도구가 기본값으로 채택 | 가장 느렸던 5% 구간에서도 18배 빠르고 더 정확 | 광고가 아니라 병합된 코드. 위험 명령 판정에 들어간 첫 사례 |
| 논문 1,018편 분류 | 총 0.08달러, 논문당 중앙값 256밀리초 | 요약은 언어모델, 판단은 Jev인 분업이 실제로 돌아간 규모 |
| 코드 리뷰 자동화 | 건당 0.00007달러, 1,000건 7센트, 검사 14종 | 사람이 표본으로 보던 검수를 전수로 돌리는 사례 |
| 한국어 조건 실측 | 한국어 조건을 영어 조건과 같은 방식으로 재면 1~4점 차 | 국내 업무에서 언어 때문에 정확도가 무너지지는 않는다는 실측 |
| 음성으로 브라우저 제어 | 명령 하나를 판단하는 데 약 300밀리초·0.0002달러 | 커뮤니티 작성자의 실측. 실시간 화면 흐름 안에 넣을 수 있는 속도 |
| 게시물 바이럴 분류(SuperX) | 게시물당 61개 질문·약 1초·0.0004달러, 실제 게시물 9,481건으로 맞춤, 두 게시물 중 3번에 2번 적중 | 작성자 측정. 무료 도구로 공개돼 직접 확인할 수 있음. "Fable 5.1과 동급에 100배 빠름"은 조건이 공개되지 않은 주장 |
| 코딩 에이전트 문맥 압축 | 100만 토큰을 8만 6천 토큰으로 1초에(게시자 표기) | 지난 대화를 요약하는 대신 도구 호출·결과마다 Jev에 남길지 물어 지웁니다. 별 2,900·MIT |
| 에이전트에 판단 스킬로 붙임 | 에이전트가 판단이 필요할 때마다 Jev에 질문(공개 스킬) | 모델을 바꾸는 대신 도구 하나를 더하는 방식. 설치 경로와 키만 있으면 켜짐 |
| AI 작성 여부 탐지 | 텍스트당 250밀리초·0.00003달러, 사람과 AI 구분 94% | "이 글은 AI가 썼는가" 질문 하나로 판정. 학습도 분류기도 없이. 사람이 쓴 글을 AI로 잘못 잡은 비율 1% |
| OMP 문맥 압축 플러그인 | 문맥 30~55% 감소, 회당 0.0005달러 | 오래된 도구 출력을 Jev로 채점해 남길 것만 남기고 나머지는 디스크로 옮깁니다. 판단 기록을 남겨 같은 결정을 다시 씁니다 |
| 드론 조종 실험 | 판단당 300밀리초, 99%는 Jev가 조종 | 화면 오른쪽에 초록(확신도)과 보라("확실하지 않음, 큰 모델에 물어봐라")가 실시간으로 뜹니다. 확신도 갈래가 눈에 보이는 사례 |
표에 실린 사례 가운데 영상으로 남은 것을 모았습니다.
표 밖에는 DuckDB 확장으로 표의 행을 분류한 기록(1,000행 약 10초), 코딩 에이전트의 품질 점수 루프, 사내 자료 공개 판정 도구, 가상 페르소나 150명에게 12문항씩 물은 시장 조사(1.8엔, 약 5초)가 있습니다.
09사용방향과 그 설계
바로 따라 할 수 있는 사용법 네 가지
첫째, 질문을 직접 던지지 말고 판단 부품으로 씁니다. 이 글에서 계속 말한 전환입니다. 언어모델에게 "이 고객문의를 읽고 알아서 처리해 줘"처럼 자유 서술 답변을 부탁하는 대신, 미리 정해 둔 질문("어느 팀이 맡아야 하나", "고객이 얼마나 화났나")에만 답을 받는 방식으로 바꾼다는 뜻입니다. 커뮤니티에서 퍼진 방식은 입력을 받아 항목별 점수를 돌려주는 기계로 만들고, 항목과 개수는 언어모델에게 설계시키고, 점수에 가중치를 곱해 코드에서 계산하는 다섯 단계입니다. TypeSafe 문서가 말하는 "복합 점수"와 같은 방식입니다.
둘째, 큰 판단을 더 쪼갤 수 없는 작은 질문으로 나누고, 코드에서 조합합니다. 언어모델이 질문지 방식으로 바꾸자 정확도·비용·속도가 모두 좋아졌고(한 모델은 51.9%에서 66.8%로), 그다음 Jev로 바꾼 이득은 정확도 1점과 비용 8분의 1이었습니다. 업무 분해가 먼저, 모델 교체가 나중입니다.
셋째, 확신도로 갈라 보냅니다. 음성 뱅킹 예시의 기준은 0.6 미만이면 사람에게 넘기고, 잔액 조회처럼 되돌릴 수 있는 일은 0.6이면 처리하며, 이체 승인처럼 되돌릴 수 없는 일은 0.85를 넘어야 자동 처리하는 것입니다. "한국 56 대 44"에 확신도 13%가 붙은 예시처럼, 숫자만 단정해 보이는 답도 확신도가 낮으면 코드가 처리하지 않습니다.
넷째, 이미 쓰는 도구 안에서 부릅니다. Vercel AI Gateway는 개발 도구(AI SDK) 7부터 evaluate라는 실험 기능으로 Jev를 부를 수 있고, DuckDB 확장은 WHERE jev(행, '이름이 유럽식인가')처럼 SQL 질의 안에서 판단을 붙입니다. 코딩 도구에는 jev-review와 claude-jev 플러그인이 있어 리뷰 지적과 디버깅 가설에 확신도를 붙이고, 낮은 것만 사람에게 남깁니다.
확신도로 갈라 보내는 설계
확신도는 모델이 "이 판단은 확실하지 않다"고 말할 수 있게 하는 장치이고, 확률분포를 숫자 하나로 접은 값이라 분포를 함께 받으면 원하는 기준으로 계산할 수 있습니다. 책임이 코드로 돌아옵니다. 판단은 확률로 오고 분기 로직은 내 코드에 남으니 검증·재현·감사가 쉬워지는 대신, 분기가 틀렸을 때 책임도 내 코드에 있습니다. 대체가 아니라 분업이고, 실제 도입 형태는 "판단만 Jev, 나머지는 언어모델"입니다.
10검증 결과
제3자 검증
Every의 평가 책임자 마이크 테일러는 자기가 Every에 올린 글 27편과 일부러 AI 흉내를 낸 대조본 10편을 Jev에 입력으로 넣고, 문서마다 똑같은 질문 21개에 대한 답을 받았습니다. 질문은 글에서 AI가 쓴 흔적을 찾는 것들로, "증거 없이 같은 생각을 반복하나", "무턱대고 양쪽 균형 주장을 강요하나", "쉬운 점을 과도하게 풀어 설명하나" 같은 물음입니다. 37개 문서에 각각 21개씩 모두 777개 판단이 0.7초에 돌아왔고, 비용은 그 합이 약 0.25센트였습니다. 그가 돌린 11개 실험 1,709개 판단의 총액도 1센트 미만이었습니다. 결함 탐지에서 글 조각당 0.35초로 비교 모델(Fable 5.1)의 8.83초를 약 25배 앞섰고 비용은 약 580분의 1이었지만, 심어 둔 결함 7개 중 6개를 잡는 데 그친 반면 비교 모델은 7개를 모두 잡았습니다.
좁은 판정의 실측은 대체로 좋습니다. 프롬프트 인젝션 662건에서 정확도 96.5%(보정오차(확신도가 실제 맞은 비율에서 벗어난 정도) 0.0588, 중앙 325밀리초), 스팸 18,514건에서 서면 정의 하나만으로 98.3%(학습 분류기 98.4%와 사실상 동률), 지역 행사 50건에서 48건으로 앞섰고, 검색 재정렬 1,617개 질문에서는 Cohere Rerank 4 Pro와 동률(0.692 대 0.691)이었습니다.
뒤집힌 결과도 있습니다. 피싱 메일 2,000건에서 62.6%로 Claude Haiku 4.5(81.3%)에 뒤졌고, 포커에서는 다섯 번 모두 올인을 골라 솔버의 최선 행동과 63% 맞았으며, 점수 쪼개기 실험은 일본어 추론이 0.837에서 0.908로 오른 대신 정상 입력 오탐이 37.2%로 나빠졌습니다. 겹쳐 보면 선이 하나입니다. 정의가 분명한 좁은 판정은 동급 이상이면서 빠르고 싸고, 판단이 어렵거나 여러 사실을 겹쳐 봐야 하는 과제에서는 뒤집힙니다. 쪼개서 코드에서 조합하라는 권고도 재현되는데, 피싱 벤치에서 Jev의 신호 5개를 회귀로 조합하니 62.6%에서 95.1%로 올랐습니다.
확산 과정에서 나온 과장으로 보이는 주장들과 그 검증
"한 시간 만에 자율주행 의사결정 루프"는 카메라 영상이 아니라 구조화된 상태 데이터를 넣은 것이었습니다. 자동 거래 봇은 실재하지만 공개 저장소의 기본값은 모의 실행이고 기본 모델도 규칙이며, 큰 누적 손실을 찍은 화면도 모의 값이었습니다. "43달러를 넣고 하룻밤에 4만 1,495달러" 수익 인증은 지갑 주소와 거래 내역이 공개되지 않았고, 같은 계정이 같은 이야기를 다른 모델로도 올렸습니다. "100배"는 측정 조건이 공개되지 않았고, 조건이 확인되는 비교는 Vercel의 18배(가장 느렸던 5% 구간 기준) 하나입니다.
출처: 참고한 자료
TypeSafe 공식 자료: 블로그 「Introducing System One Models & Jev」(2026.09.15) · 「The Bitterest Lesson」(2026.09.10) · 「Lies, Damned Lies, and Benchmarks」(2026.09.11) · 매니페스트 「Composable AI: Build Prod, Not God」 · 팀 페이지 · 문서 docs.typesafe.ai(Introduction·System One·State·Primitives·Confidence·Patterns·Use case map·Models·API reference) · 워크플로 평가 페이지 · 구조화 출력 오류율 도표
영상: Matija Sosic 46초 요약 영상(2026.09.16, X) · 디오고 알메이다 런치 영상(2026.09.15, X, 2분 56초) · Doom 데모 게시물
투자·보도: 「TypeSafe AI Emerges From Stealth With $40M in Funding」(2026.09.15, 보도자료) · 포브스 · 딜룸 · AI News(2026.09.16) · The Register(2026.09.16)
검증에 쓴 공식 자료: Vercel 체인지로그 「TypeSafe AI's Jev now available on AI Gateway」(2026.09.16) · Vercel 저장소 vercel/eve 도구 승인 변경(2026.09.17 병합) · vercel-labs/fx 저장소 · Vercel CEO 게시물(18배) · Cua Driver jev-use(Cua 게시물 2건(2026.09.17·09.18) · trycua/cua 저장소 jev-use 레시피 병합 PR #3916 · 화면 파싱 확장 초안 PR #3943 · CUA-S1 계열 RFC #3962·소스 병합 PR #3964 · 모델 카드 cua-ai/cua-s1-forms(MIT) · Hacker News 「Introducing System One Models and Jev」(2026.09.15, 1,855점)
제3자 검증: Every 「Mini-Vibe Check: TypeSafe's Jev Judged Everything I've Written in 0.7 Seconds」(2026.09.15, 마이크 테일러·Every 평가 책임자) · 같은 매체 대표 댄 시퍼의 글 12편 검사 · 제3자 벤치마크(2026.09.16~17): jev-sec-bench(프롬프트 인젝션 662건) · jev-spam-eval(메일 18,514건) · jev-rerank-bench(질문 1,617개) · jev-phishing-bench(피싱 메일 2,000건) · Near Here 이벤트 검증 · 포커 판정 프로브(backnotprop) · 항목 점수 분해 실험(agentjournal)
과장 검증에 쓴 자료: 거래 봇 저장소 jarrodwatts/jev-trader(공개 배포본은 모의 실행·mock 모델) · aowang-ai/jev-trade(기본값 dry run) · GPT-6 Astra 자동매매 주장 검증(2026.09.08, 지갑·거래 내역 미공개, 같은 계정이 하루 전 Grok Bot으로 같은 이야기 게시)
직접 실측: Cua Driver 0.28.2 · typesafe-sdk 0.6.0 · 모델 jev-1.13.0 (2026.09.20, 격리 브라우저에서 같은 작업 2회씩, 성공 판정은 폼 밖 확인 주소로 독립 확인) · 호출 횟수 재현(문서 6천 자·질문 13개, 3회, 묶어 묻기와 나눠 묻기 비교)
커뮤니티 실사용: 논문 분류(@nutlope) · 코드 리뷰(@redp314) · 한국어 벤치마크(@mahler83) · 음성 브라우저(@moritzkremb) · DuckDB 확장(@hamiltonulmer) · 커뮤니티 디렉터리 awesome-jev · madewithjev.com(2026.09.19 기준 186건, TypeSafe 비제휴 명시·등록자 신고 값) · Jevable(jevable.com, 만든 사람 Nikunj, 359건, 각 항목이 원문 게시물로 연결) · jev-review 플러그인 · 쿼리·RAG 제안(@eiaserinnys) · 복합 점수 사용법(@AM09_21) · 사회적 판단 예시(@acidsound) · 화면 조작 기록(Milind Soni @milindlabs·OpenMausBot) · typesafe-computer-use(Andrew Levin) · 게시물 바이럴 분류(@robj3d3·SuperX) · 문맥 압축 플러그인(tamaratran/fast-jev-compaction) · 판단 스킬(shantanugoel/ask-jev-skill) · Qiita 「Jev란 무엇인가」(2026.09.17) · AI 작성 탐지(@redp314) · OMP 문맥 압축(@jerry543) · 드론 조종 실험(@MKhordoo) · 휴대폰 단계 검증(@sudo_rudra)
확산 과정의 주장: @NFT_Chen(자율주행) · @oragnes(자동 거래) · @savboj(100배) · jarrodwatts/jev-trader 저장소